On entend parler d'IA et d'agents IA partout, en boucle. Certains parlent même de bulle. Et pourtant, les faits sont là : un agent bien conçu fait gagner du temps, et pas qu'un peu !
Dans cet article, nous vous proposons d'étudier les raisons qui font déraper certains agents, avant de finir par le meilleur : comment, chez BEKLAB, nous délimitons le rôle de l'agent et mettons en place les solutions qui le rendent vraiment utile, au quotidien.
Oui, un agent IA peut échouer
Les chiffres font peur au premier abord. En juin 2025, Gartner a prévu que plus de 40 % des projets d'IA agentique seraient annulés d'ici fin 2027. Un an plus tard, le cabinet ajoute que le coût de fonctionnement de l'IA, pour chaque tâche confiée à un agent, sera multiplié par plus de cinq d'ici 2028. Il prévoit aussi que 70 % des entreprises abandonneront d'ici 2028 les agents construits sur mesure par les ingénieurs d'un fournisseur.
Derrière ces prévisions, on retrouve des causes très concrètes :
- Un besoin mal qualifié. On met un agent partout parce que c'est à la mode. Or un agent n'est pas toujours nécessaire. Quand une tâche suit toujours les mêmes règles, une automatisation classique, qui fait exactement ce qu'on lui demande, est plus fiable et moins chère.
- Une solution clé en main pour un métier technique. Un abonnement généraliste suffit pour rédiger un mail. Il ne connaît ni votre jargon, ni vos règles, ni vos cas particuliers. Quand on exerce un métier technique, il faut un outil ou un agent sur mesure.
- Un manque de compétences techniques. Un agent fiable demande de maîtriser la recherche dans les documents, leur découpage, la mémoire, les droits d'accès. Sans ces compétences, on assemble des briques qui fonctionnent en démonstration, pas au quotidien.
- Un contexte mal compris. L'agent ne comprend que ce qu'on lui donne. Trop de sources, ou des sources mal cataloguées, et il ne sait plus où chercher ni laquelle croire. Des documents mal découpés, et il récupère une demi-information : la condition sans son exception, le tarif sans sa date de validité. Aucun lien entre les documents, et il ne voit pas qu'un devis, une facture et un mail concernent le même client.
- Une mémoire limitée. Un agent ne peut garder qu'une quantité limitée d'informations à la fois. Sans mémoire à long terme, il oublie tout d'une conversation à l'autre, ou relit tout l'historique, ce qui coûte cher.
- Aucune limite de budget. Sans consigne claire pour s'arrêter, l'agent peut refaire la même tâche encore et encore. On parle de « looping ». Personne ne le voit tourner, mais chaque tour est facturé.
- Une sécurité mal pensée. Un agent qui peut tout lire et tout modifier peut aussi tout casser. On ne confie pas les clés de tout le bâtiment à une recrue le premier jour.
Et pourtant, un agent bien construit tient ses promesses
Pas de quoi s'inquiéter pour autant : aucune de ces causes n'est une fatalité. Toutes se traitent en amont, avant même de lancer l'agent.
Et le jeu en vaut la chandelle. En mars 2026, le SBE Council, une association américaine de petites entreprises, a interrogé 517 employeurs de 2 à 99 salariés. En médiane, les dirigeants gagnent 5 heures par semaine grâce à l'IA, et leurs équipes 11,5 heures. Deux tiers voient aussi leur chiffre d'affaires progresser. L'étude porte sur les outils d'IA en général, et son message est clair : bien utilisée, l'IA rend du temps.
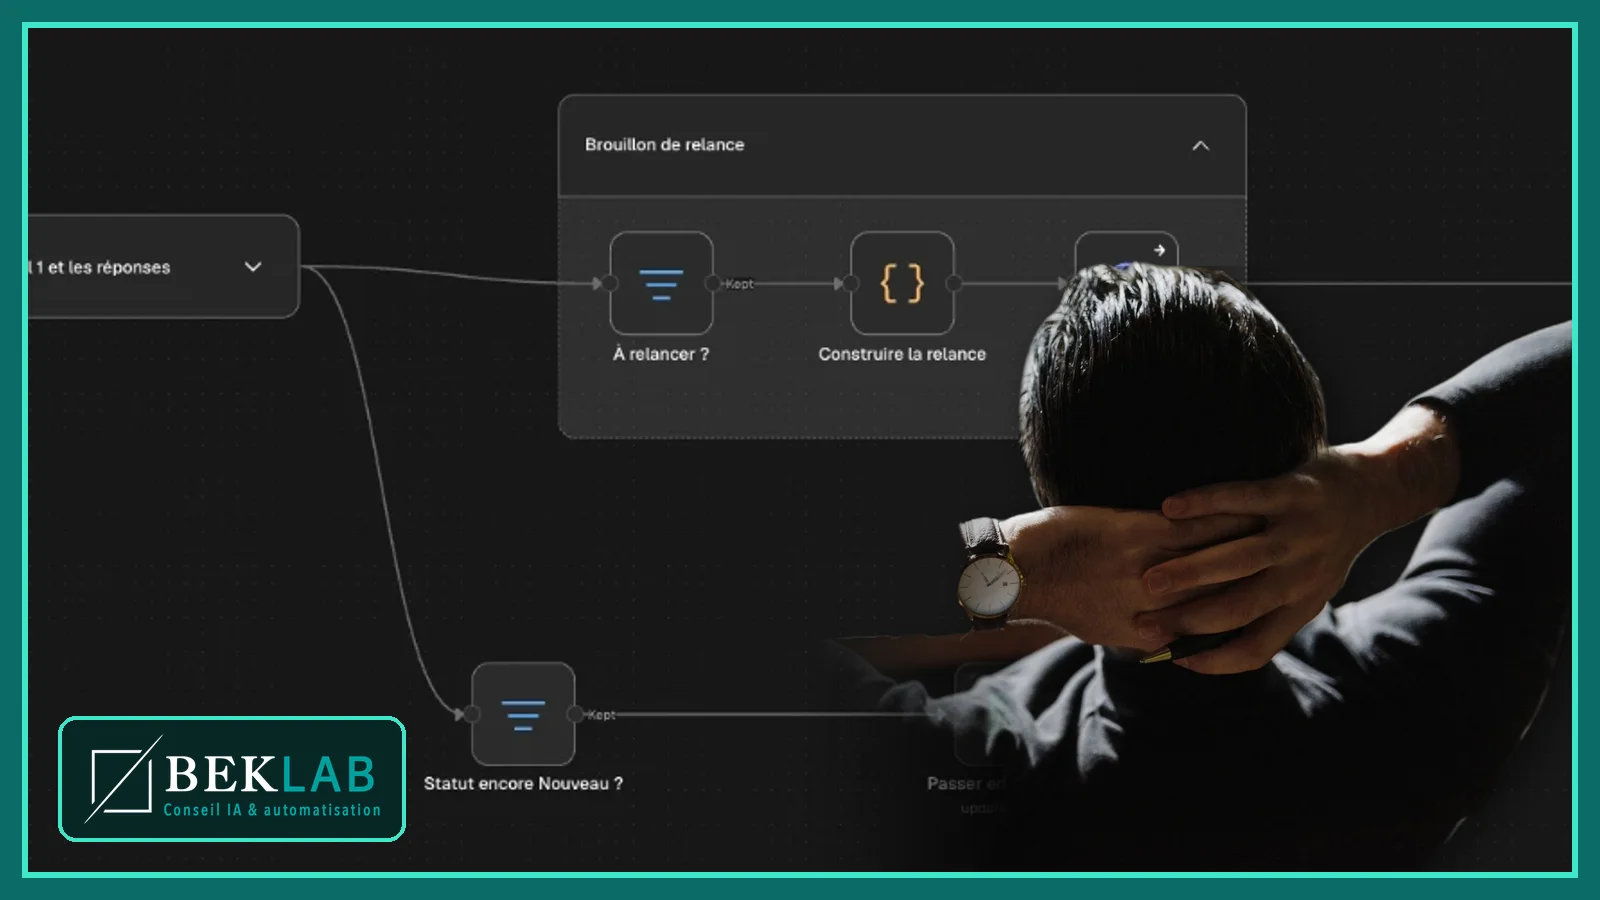
Concrètement, un agent peut trier vos demandes, préparer des réponses, retrouver une information dans vos documents ou relancer un client au bon moment. Le piège, c'est de se lancer seul avec un outil trouvé en ligne et un tutoriel. L'agent fonctionne le premier jour, puis la facture grimpe et personne ne sait corriger l'erreur. C'est exactement le scénario que décrit Gartner.
La différence se joue ainsi avant le lancement : un besoin bien qualifié, des données bien segmentées, une mémoire à long terme et des garde-fous adaptés. C'est là que nous intervenons.
Comment nous en faisons un allié
Notre méthode reprend une à une les causes d'échec.
- Qualifier le besoin avant tout. Nous commençons par la tâche, pas par l'outil. Si elle suit toujours les mêmes règles, une automatisation classique suffit. L'agent n'intervient que là où il faut comprendre, interpréter ou décider. Nous fixons aussi, dès le départ, le gain attendu.
- Du sur-mesure, pas un abonnement généraliste. L'agent est construit pour votre métier, avec votre vocabulaire, vos règles et vos cas particuliers.
- Des sources choisies et bien cataloguées. Inutile de tout ramener à une source unique. L'important est de ne pas multiplier les sources, et que chacune soit rangée, identifiée et à jour. L'agent sait alors où chercher.
- Un découpage fait à la main. Nous ne laissons pas un outil couper vos documents au hasard. Nous les divisons nous-mêmes, idée par idée, pour que chaque morceau ait du sens seul. Quand une information est à cheval sur deux parties, nous faisons se chevaucher les morceaux pour qu'elle ne soit jamais coupée en deux.
- Des informations reliées et une mémoire à long terme. L'agent sait qu'un devis, une facture et un mail parlent du même client. Il se souvient de ce qui compte d'une conversation à l'autre, sans relire tout l'historique.
- Des droits adaptés à chaque tâche. Un agent qui répond à des questions n'a besoin que de lire. Un agent qui prépare des relances peut écrire des brouillons, sans les envoyer. Chaque action reçoit exactement les droits dont elle a besoin, et les actions sensibles passent par une validation humaine.
- Un budget plafonné et surveillé. Un plafond par jour et par demande coupe court à l'effet de boucle. Si l'agent tourne en rond, il s'arrête et prévient un humain.
Reste la prévision de Gartner sur les agents construits par les fournisseurs. Elle vise les projets dont l'entreprise ne peut ni comprendre ni faire évoluer le résultat. Gartner recommande de régler dès le départ la gouvernance, la propriété du travail, le transfert de connaissances et la sortie du prestataire.
C'est notre façon de travailler. Les automatisations que nous construisons tournent sur vos outils, sont documentées et restent modifiables par votre équipe. Vous gardez la main, avec ou sans nous. Et vous n'avez pas besoin de comprendre la technique : c'est notre rôle.
Pour savoir si un agent a du sens dans votre activité, réservez un pré-audit gratuit. Pour aller plus loin, lisez agent IA ou automatisation et découvrez nos agents IA.
Pour les curieux de la technique
Cette partie s'adresse à ceux qui veulent voir ce qui se passe sous le capot.
Pourquoi l'architecture de données classique échoue
Les bases de données traditionnelles (SQL ou NoSQL) et le RAG de première génération, qui se limite à une recherche vectorielle simple, ont été pensés pour des humains. Pas pour des agents autonomes. Sans refonte, l'agent échoue pour trois raisons :
- L'incohérence coûte cher. Face à des données cloisonnées ou contradictoires, l'agent multiplie les requêtes et les appels d'API, parfois en boucle. La rentabilité du projet disparaît.
- Des données figées pour des actions réelles. Pour agir sans erreur métier, comme valider une commande frauduleuse, l'agent a besoin de données rafraîchies à la seconde. C'est le rôle d'une architecture orientée événements (EDA).
- L'absence de limites. Le principe du moindre privilège s'applique aussi aux agents : chacun n'accède qu'aux données dont il a besoin, pour ne jamais modifier ou détruire par accident une base critique.
Bien découper ses documents
Le RAG repose sur des morceaux de texte, les chunks, transformés en vecteurs puis stockés dans une base vectorielle. Une découpe automatique à taille fixe coupe souvent au mauvais endroit. Une découpe par sens (titre, paragraphe, clause) donne des morceaux autonomes. Un chevauchement de quelques phrases entre deux chunks évite de perdre ce qui se trouve à la frontière.
La mémoire à long terme, au-delà du RAG
Obsidian sert de base de connaissances. Vos notes y sont de simples fichiers Markdown, reliées entre elles par des liens : Obsidian a donc déjà des capacités de graphe. Le RAG, lui, est le moteur de recherche qui fouille ces notes. Pour qu'un agent soit vraiment efficace, il lui faut en plus une couche de mémoire persistante.
La stack idéale réunit ainsi Obsidian (les fichiers Markdown), un serveur MCP (le protocole qui transmet le contexte à l'agent), un gestionnaire de mémoire et un framework d'agent comme LangGraph ou AutoGen.
Côté mémoire, quatre outils se distinguent :
- Mem0, le calque sémantique. Il extrait et retient seulement les faits marquants et les préférences d'une session à l'autre, par exemple « l'utilisateur préfère Python et uv ». Plus besoin de recharger tout l'historique.
- Zep et Graphiti, le graphe temporel. Ils gèrent la chronologie des faits et savent qu'un fait A a été remplacé par un fait B.
- Letta (ex-MemGPT), le système d'exploitation de la mémoire. L'agent écrit, modifie et archive lui-même ses blocs de mémoire grâce à des fonctions.
- Cognee, l'extraction de graphes. Il analyse vos notes Obsidian et en tire des concepts et des relations, sous forme de graphes de connaissances locaux.
La stack idéale avec n8n
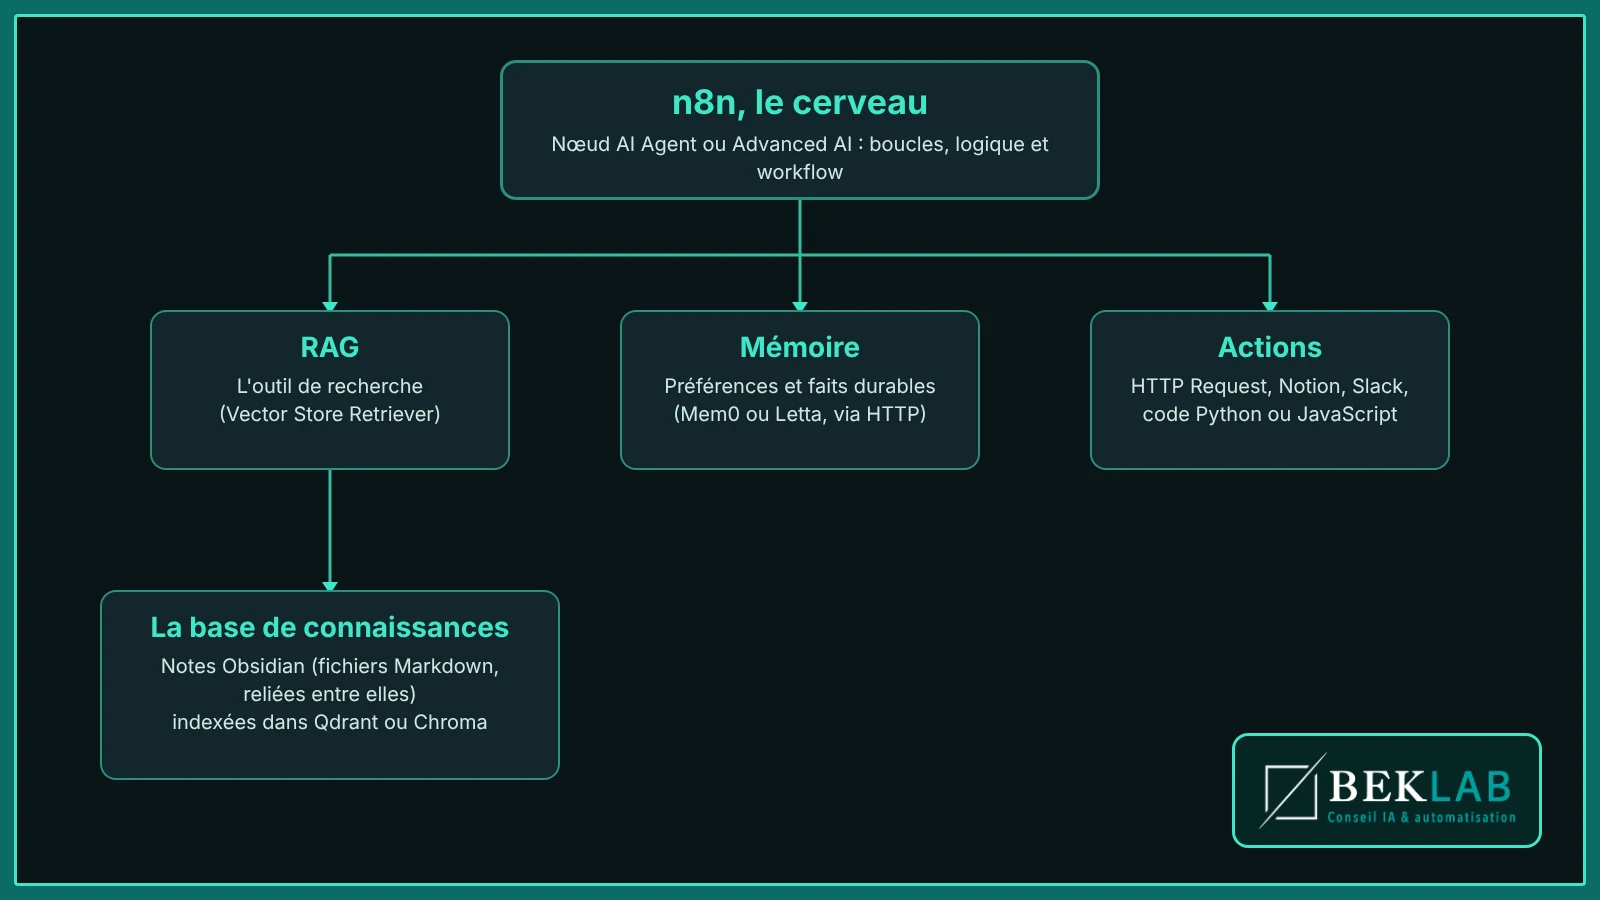
Voici le rôle de chaque composant :
- n8n, le cerveau. C'est le chef d'orchestre. Le nœud AI Agent ou Advanced AI reçoit la demande, fait réfléchir le modèle de langage et décide quels autres nœuds activer.
- Le RAG, l'outil de recherche. Intégré à n8n, il passe par le nœud Vector Store Retriever relié au modèle. n8n l'active dès qu'il doit fouiller dans vos connaissances.
- Obsidian et la base vectorielle, la base. Vos notes Obsidian sont synchronisées et indexées dans une base vectorielle comme Qdrant, Pinecone ou Chroma. C'est elle que n8n interroge.
- Mem0 ou Letta, la mémoire à long terme. n8n les appelle avec le nœud HTTP Request. Au début du workflow, il charge le profil de l'utilisateur, par exemple « préfère un Markdown dense ». À la fin, il enregistre les nouveaux faits appris.
- Les autres nœuds, l'action. Requêtes HTTP, Notion, Slack ou code Python et JavaScript exécutent ce qui a été décidé.
Chaque brique se remplace sans tout reconstruire. Et chaque appel passe par n8n, ce qui permet d'y placer les plafonds de budget et les validations humaines.